Identificación del fonema final
Ficha automática · CF_IDENTIFICACION_FONEMA_FINAL
En una frase. Mide conciencia fonémica (aislamiento del fonema final) de 5 a 6 años (2.251 aplicaciones en 4 cohortes). AUC .76 frente a la dificultad lectora persistente.
Descripción
| Códigos | 1897 |
| Batería | LEEDUCA |
| Formato | elección entre opciones |
| Ítems | 10 (1897) según la plataforma |
| Familia de ficha | A · Precisión |
| Puntuación | Aciertos |
| Consigna (plataforma) | Esta tarea consiste en identificar y pronunciar el fonema FINAL de cada una de las sílabas que pronuncia el evaluador o la evaluadora. Cada ítem de la prueba es una sílaba con estructura CVC. |
Cómo está programada en la plataforma
La plataforma es la referencia: lo que reproduce la actividad es lo que se mide. Configuración leída de la propia actividad el 22/10/2026 (sin modificarla).
| Código | Nombre en la plataforma | Presentación | Ítems de prueba | Ítems de práctica | Ejemplos de ítems | Límite de tiempo | Orden | Puntuación | Edad.trimestre (etiqueta 3) |
|---|---|---|---|---|---|---|---|---|---|
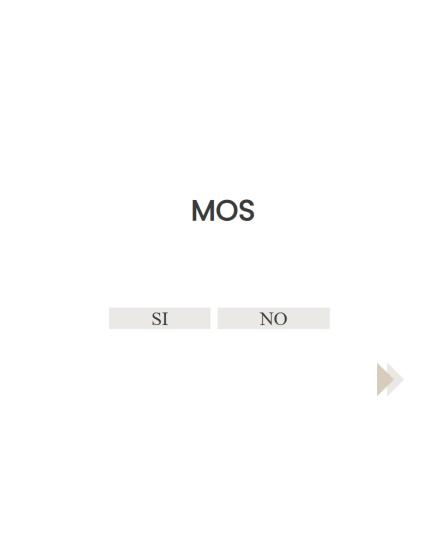
| 1897 | Identificar fonemas | Pseudopalabra CVC escrita; el evaluador marca SÍ/NO | 10 | 0 | MOS, FER (ejemplos orales previos: SOL, LEN, MIR) | sin límite | fijo | Aciertos | 5.1, 6 |
Diferencias con el diccionario o las instrucciones:
- 1897. 10 ítems CVC. Los ejemplos (SOL, LEN, MIR) son orales, fuera de la plataforma: no hay ítems de ejemplo registrados.
Edad.trimestre: lectura provisional de la etiqueta 3 de la actividad (3.ª cifra = edad, 4.ª = trimestre; 0 = anual), pendiente de confirmar con el ingeniero.
Así se ve en la plataforma (primer ítem o ejemplo; captura de 2026).
Marco teórico
La conciencia fonológica es la capacidad de reflexionar sobre los sonidos del habla y manipularlos. Las tareas de la plataforma recorren un continuo de dificultad:
- por la unidad: sílaba o fonema;
- por la operación: contar, identificar, segmentar o suprimir;
- por la posición: inicial, final o cualquiera.
La versión «todas las posiciones» mezcla ítems y es la más exigente.
Qué dice la evidencia:
- El fonema y la manipulación son lo que más distingue a la dislexia. En 2.252 niños de seis lenguas europeas, la supresión de fonemas y el RAN fueron los predictores concurrentes más fuertes de la dislexia (Landerl et al. 2013). En ortografías consistentes, los niños con dislexia rinden por debajo incluso de lectores más pequeños de su mismo nivel en las tareas de manipular fonemas, pero no en las de sílabas (Parrila et al. 2020).
- En español, la conciencia fonológica se desarrolla por etapas, de la sílaba al fonema. La conciencia fonémica se apoya en el aprendizaje de la lectura y a la vez lo impulsa: la relación es recíproca (Denton et al. 2000). La conciencia fonológica predice sobre todo la lectura de sílabas complejas (Martínez y Goikoetxea 2020).
- Su valor predictivo es universal, pero cambia con la edad. La conciencia fonémica, las letras y el RAN predicen el crecimiento lector igual en español, checo e inglés (Caravolas et al. 2013). En cambio, su relación con la fluidez es más compleja y depende de la tarea y de la edad, mientras que el RAN predice la fluidez en todas las lenguas (Landerl et al. 2019). Es lo esperable según Catts, Haynes, y Joshi (2026): los precursores sirven para el pronóstico temprano y pierden peso cuando ya hay lectura que medir.
Las fichas piloto desarrollan este marco con más detalle: contar sílabas y denominación rápida.
Lo que muestran nuestros datos. El patrón coincide con la literatura:
- Lo que más predice. Las tareas de supresión en todas las posiciones son las que mejor predicen la baja fluidez de Woodcock-Muñoz (AUC mediano .72–.73, hasta .81).
- En un punto intermedio. Las demás tareas de supresión e identificación (.63–.68).
- Lo que menos predice. Segmentar fonemas y contar sílabas (.60–.62).
- Consistencia y estabilidad. La consistencia interna es buena (α = .82–.94), pero la estabilidad entre trimestres es baja (ρ = .27–.41). Muchas se aplicaron en solo una o dos sesiones y los niños cambian deprisa en estas edades. Para un diagnóstico individual conviene confirmar el resultado en dos momentos.
Muestra y descriptivos
| Momento | Cohorte | Sesión | Curso escolar | N | Sin Preleo | Con Preleo | Colegios |
|---|---|---|---|---|---|---|---|
| 5.1 | 2012 | 182 | 2017/18 | 1 | 1 | 0 | 1 |
| 6.1 | 2010 | 152 | 2016/17 | 914 | 262 | 651 | 34 |
| 6.1 | 2011 | 183 | 2017/18 | 777 | 0 | 772 | 31 |
| 6.1 | 2013 | 898 | 2019/20 | 559 | 400 | 159 | 35 |
| Momento | N | Cohortes | Media | DT | Mediana | Asimetría | % suelo | % techo |
|---|---|---|---|---|---|---|---|---|
| 6.1 | 662 | 2010, 2013 | 6,97 | 3,11 | 8 | -0,87 | 5,44 | 28,70 |
Rango de puntuaciones (grupo SIN, en aciertos). El rango habitual va del P1 al P99 (el 98 % de los niños). El mínimo–máximo es el observado tras la limpieza; el rango posible es 0–10 aciertos.
| Momento | N | Rango habitual (P1–P99) | Mín.–máx. | Rango posible | Aviso |
|---|---|---|---|---|---|
| 6.1 | 662 | 0–10 | 0–10 | 0–10 |
Fiabilidad
No hay dos momentos con los mismos niños (al menos 80). α (2021) = .86.
Validez
Concurrente. Con otras tareas de su mismo dominio (Conciencia fonológica), r = .73. Fuera de su dominio, la relación más alta es con: Lectura de palabras y texto (6.1, r = .58).
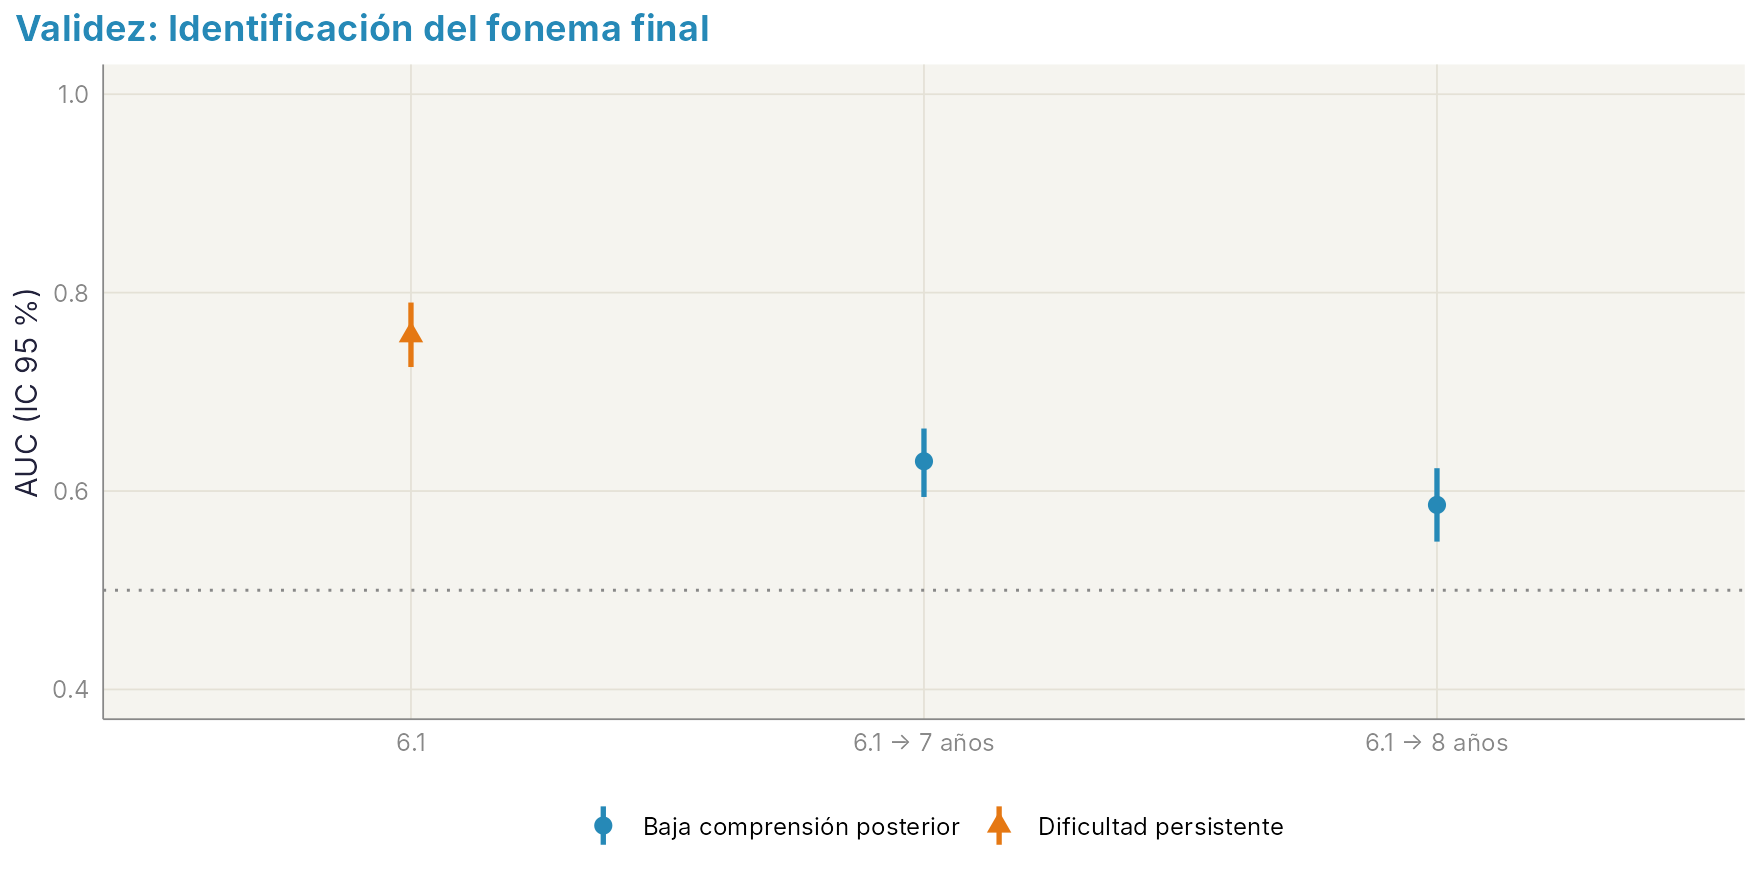
Frente a la dificultad lectora y la comprensión. Frente a la dificultad persistente, AUC .76. Frente a la baja comprensión uno o dos cursos después (criterio no circular), AUC .59–.63.
Frente a un criterio externo, años después. Frente a la baja fluidez lectora de Woodcock-Muñoz en 2021/22 (capítulo), AUC .67 (1 momento; 676–676 niños).
Baremo provisional
| Momento | N | Cohortes | P5 | P10 | P16 | P25 | P50 | P75 | P90 |
|---|---|---|---|---|---|---|---|---|---|
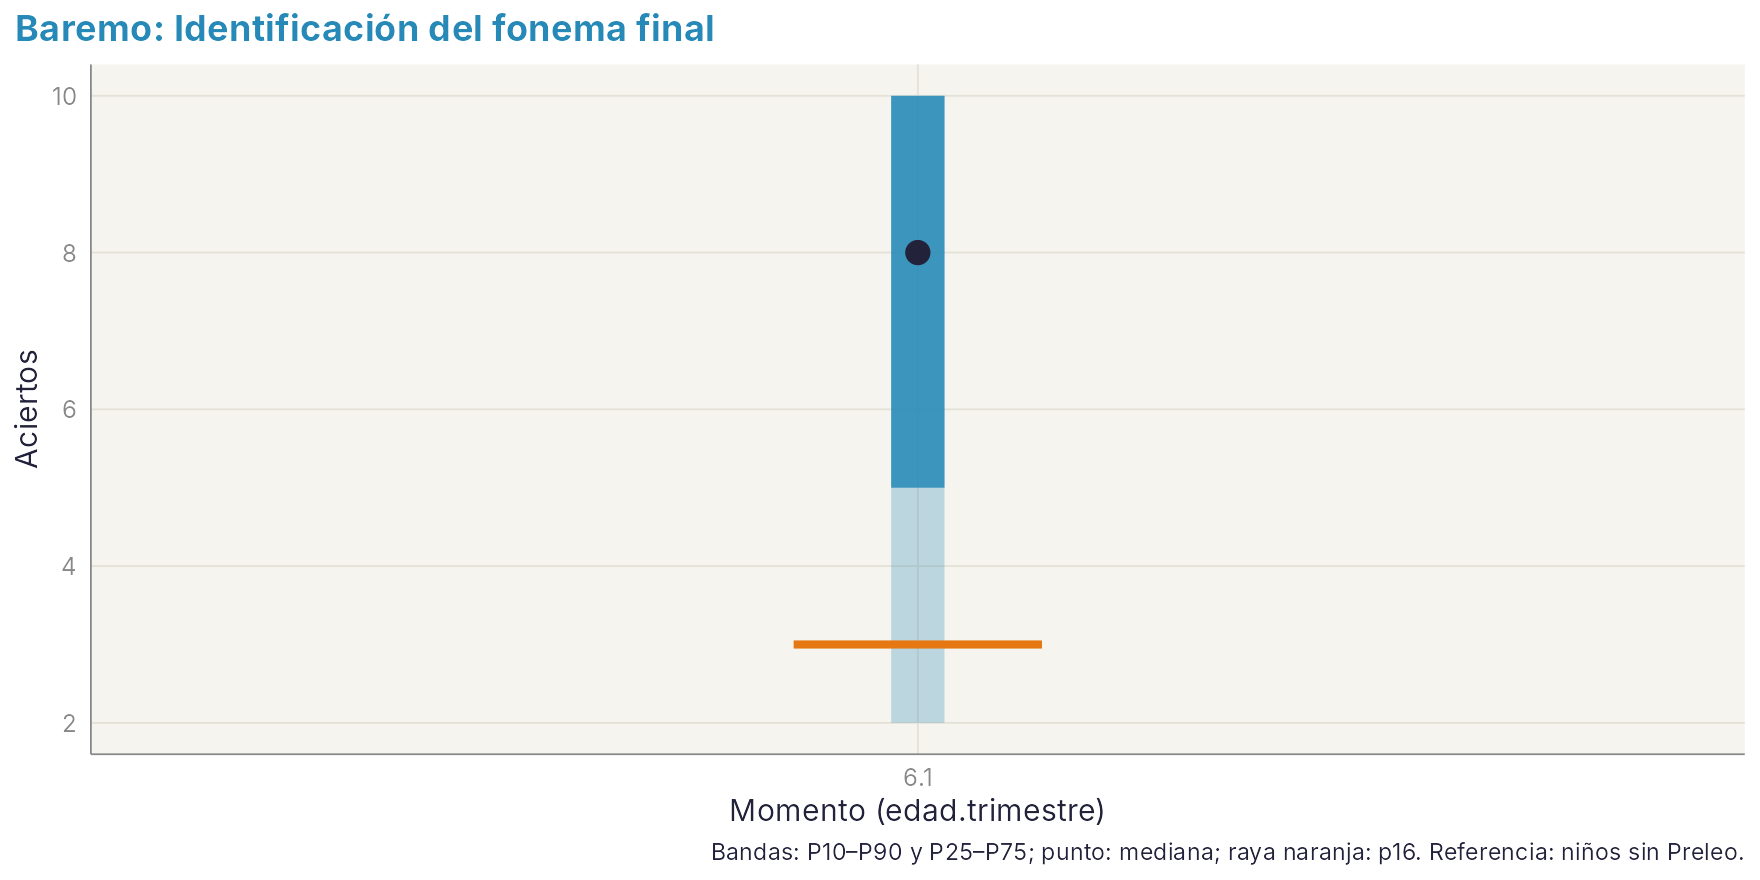
| 6.1 | 662 | 2010, 2013 | 0 | 2 | 3 | 5 | 8 | 10 | 10 |
Variables que la afectan
| Variable | Momento | n | Efecto | p |
|---|---|---|---|---|
| ISE del centro (ρ) | 6.1 | 2.237 | 0,137 | 0,000 |
| Sexo (d niña − niño; codificación en revisión) | 6.1 | 2.243 | 0,068 | 0,105 |
| Edad relativa (ρ con la edad en meses) | 6.1 | 2.240 | 0,056 | 0,008 |
| Colegio (CCI) | 6.1 | 2.250 | 0,172 |
Para publicaciones
Español. La tarea «Identificación del fonema final» de la plataforma LEEDUCA (código 1897; batería LEEDUCA) evalúa la conciencia fonémica (aislamiento del fonema final). El niño elige su respuesta entre las opciones presentadas en la pantalla. Consta de 10 ítems. El tiempo máximo es de 120 segundos. Se aplica de forma individual, con ordenador, en el propio centro escolar. En las cohortes 2010, 2011, 2012 y 2013 se aplicó en 4 sesiones, de 5 a 6 años. La medida principal es el número de aciertos. En nuestros datos (análisis de 2021), la consistencia interna fue α = .86 (N = 2.321, 10 ítems). Frente a la baja comprensión posterior, AUC = .59–.63.
English. The LEEDUCA platform task “Final phoneme isolation” (code 1897; LEEDUCA battery) assesses phonemic awareness (final phoneme isolation). The child selects a response among the options presented on the screen. It comprises 10 items. The time limit is 120 seconds. It is administered individually on a computer at school. In the 2010, 2011, 2012 and 2013 cohorts it was administered in 4 sessions, from 5 to 6 years of age. The main outcome is the number of correct responses. In our data (2021 analyses), internal consistency was α = .86 (N = 2,321, 10 items). Against later poor reading comprehension, AUC = .59–.63.
Pendientes e incidencias
- Efecto techo en 6.1 (más del 15 % de los niños con la puntuación máxima).
- Escribir el marco teórico y la interpretación; revisar con el equipo.
Tablas completas datos/agregados/AUTO_CF_IDENTIFICACION_FONEMA_FINAL/
0 Ficha datos/agregados/AUTO_CF_IDENTIFICACION_FONEMA_FINAL/0_Ficha.csv
| tarea_canonica | tarea | familia | puntuacion | codigos | clase | items | circular_con_etiqueta |
|---|---|---|---|---|---|---|---|
| CF_IDENTIFICACION_FONEMA_FINAL | Identificación del fonema final | A | Aciertos | 1.897 | A | 10 | FALSE |
0 Limpieza datos/agregados/AUTO_CF_IDENTIFICACION_FONEMA_FINAL/0_Limpieza.csv
| cohorte | mom | n | motivo |
|---|---|---|---|
| 2010 | 6.1 | 8 | sin aciertos válidos |
| 2011 | 6.1 | 4 | sin aciertos válidos |
| 2012 | 5.1 | 319 | sin aciertos válidos |
1 Muestra datos/agregados/AUTO_CF_IDENTIFICACION_FONEMA_FINAL/1_Muestra.csv
| mom | cohorte | sesion | curso_escolar | plataforma | N | SIN | CON | colegios | pct_con_ISE |
|---|---|---|---|---|---|---|---|---|---|
| 5.1 | 2012 | 182 | 2017/18 | antigua | 1 | 1 | 0 | 1 | 100 |
| 6.1 | 2010 | 152 | 2016/17 | antigua | 914 | 262 | 651 | 34 | 100 |
| 6.1 | 2011 | 183 | 2017/18 | antigua | 777 | 0 | 772 | 31 | 98 |
| 6.1 | 2013 | 898 | 2019/20 | nueva | 559 | 400 | 159 | 35 | 100 |
2 Descriptivos SIN datos/agregados/AUTO_CF_IDENTIFICACION_FONEMA_FINAL/2_Descriptivos_SIN.csv
| mom | N | cohortes | M | DT | Md | asimetria | minimo | P1 | P99 | maximo | pct_suelo | pct_techo |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 6.1 | 662 | 2010, 2013 | 6,97 | 3,11 | 8 | -0,87 | 0 | 0 | 10 | 10 | 5,44 | 28,70 |
2b Descriptivos por cohorte datos/agregados/AUTO_CF_IDENTIFICACION_FONEMA_FINAL/2b_Descriptivos_por_cohorte.csv
| mom | cohorte | plataforma | N | cohortes | M | DT | Md | asimetria | minimo | P1 | P99 | maximo | pct_suelo | pct_techo |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 5.1 | 2012 | antigua | 1 | 2012 | 6,00 | 6 | 6 | 6 | 6 | 6 | 0,00 | 0,00 | ||
| 6.1 | 2010 | antigua | 914 | 2010 | 6,99 | 3,01 | 8 | -0,93 | 0 | 0 | 10 | 10 | 5,80 | 25,60 |
| 6.1 | 2011 | antigua | 777 | 2011 | 7,04 | 2,87 | 8 | -1,04 | 0 | 0 | 10 | 10 | 4,76 | 20,33 |
| 6.1 | 2013 | nueva | 559 | 2013 | 7,18 | 3,10 | 8 | -1,03 | 0 | 0 | 10 | 10 | 6,44 | 30,95 |
4a Validez concurrente datos/agregados/AUTO_CF_IDENTIFICACION_FONEMA_FINAL/4a_Validez_concurrente.csv
| mom | dominio | n | r | rho |
|---|---|---|---|---|
| 6.1 | Conciencia fonológica | 2.250 | 0,73 | 0,64 |
| 6.1 | Lectura de palabras y texto | 2.247 | 0,58 | 0,54 |
| 6.1 | Conocimiento de letras | 2.248 | 0,47 | 0,52 |
| 6.1 | Morfosintaxis oral | 2.240 | 0,39 | 0,37 |
| 6.1 | Memoria verbal | 1.675 | 0,31 | 0,29 |
| 6.1 | Vocabulario y comprensión oral | 2.245 | 0,22 | 0,21 |
| 6.1 | Denominación rápida (RAN) | 1.691 | 0,15 | 0,24 |
4b Validez frente etiqueta datos/agregados/AUTO_CF_IDENTIFICACION_FONEMA_FINAL/4b_Validez_frente_etiqueta.csv
| mom | n | casos | AUC | IC_inf | IC_sup | sens_p25 | esp_p25 | lectura |
|---|---|---|---|---|---|---|---|---|
| 6.1 | 1.652 | 265 | 0,76 | 0,72 | 0,79 | 0,47 | 0,87 | Predictiva o concurrente (la etiqueta no usa esta tarea) |
4c Baja comprension posterior datos/agregados/AUTO_CF_IDENTIFICACION_FONEMA_FINAL/4c_Baja_comprension_posterior.csv
| desde | criterio | n | casos | AUC | IC_inf | IC_sup |
|---|---|---|---|---|---|---|
| 6.1 | Baja comprensión (≤ p25) a los 7 años | 1.291 | 327 | 0,63 | 0,59 | 0,66 |
| 6.1 | Baja comprensión (≤ p25) a los 8 años | 1.004 | 264 | 0,59 | 0,55 | 0,63 |
5 Baremo SIN datos/agregados/AUTO_CF_IDENTIFICACION_FONEMA_FINAL/5_Baremo_SIN.csv
| mom | referencia | N | cohortes | P5 | P10 | P16 | P25 | P50 | P75 | P90 | P95 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 6.1 | SIN Preleo | 662 | 2010, 2013 | 0 | 2 | 3 | 5 | 8 | 10 | 10 | 10 |
6 Efectos variables datos/agregados/AUTO_CF_IDENTIFICACION_FONEMA_FINAL/6_Efectos_variables.csv
| variable | mom | n | efecto | p |
|---|---|---|---|---|
| ISE del centro (ρ) | 6.1 | 2.237 | 0,14 | 0,00 |
| Sexo (d niña − niño; codificación en revisión) | 6.1 | 2.243 | 0,07 | 0,10 |
| Edad relativa (ρ con la edad en meses) | 6.1 | 2.240 | 0,06 | 0,01 |
| Colegio (CCI) | 6.1 | 2.250 | 0,17 |